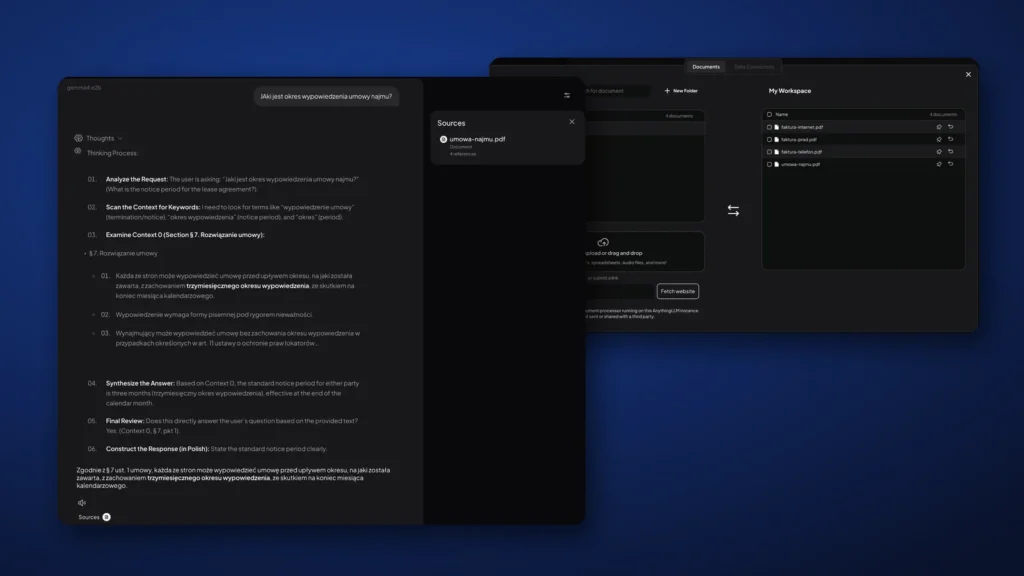
Gemma na Ollamie potrafi odpowiadać na pytania o Twoje pliki bez wysyłania ich do chmury: wystarczy Ollama z modelem Gemma 4, model do indeksowania EmbeddingGemma i darmowy program AnythingLLM. Sprawdziłem to na 10-letnim laptopie bez karty graficznej. Odpowiedzi były poprawne i podane ze źródłem, ale każda trwała od niecałych 4 do 10,5 minuty. Do tego trzy domyślne ustawienia AnythingLLM trzeba zmienić ręcznie, a jedno z nich (tryb Agent) wysłało moje pytanie do internetu zamiast do dokumentów.
Na czym testowałem
Test zrobiłem 12-14 października 2026 r. na moim Dellu Latitude E7250:
| Element | Wersja |
|---|---|
| Procesor | Intel Core i5-5300U (2 rdzenie, 4 wątki) |
| Pamięć | 16 GB RAM |
| Karta graficzna | zintegrowana Intel HD 5500, Ollama jej nie używa |
| System | Ubuntu 26.04.1 LTS |
| Ollama | 0.40.3 |
| AnythingLLM Desktop | 1.17.0 |
| Modele | gemma4:e4b, gemma4:e2b, embeddinggemma |
Jako dokumenty wgrałem cztery PDF-y z fikcyjnymi danymi: 4-stronicową umowę najmu i trzy faktury (prąd, internet, telefon). Znałem więc poprawne odpowiedzi i mogłem sprawdzić, czy model nie zmyśla.
Jeśli Twój komputer ma kartę graficzną NVIDIA albo jest to Mac z procesorem Apple, odpowiedzi będą dużo szybsze. Ten test pokazuje najgorszy realny przypadek. Ile pamięci i jakiego sprzętu potrzeba, opisałem w artykule o wymaganiach sprzętowych do lokalnego AI.
Jak to działa w skrócie
Model językowy nie czyta od razu całego folderu. AnythingLLM dzieli dokumenty na fragmenty, zamienia je na liczby (tzw. embedding) i zapisuje w lokalnej bazie. Gdy zadajesz pytanie, program wyszukuje kilka najbardziej pasujących fragmentów i tylko je przekazuje Gemmie. Taka technika nazywa się RAG.
Na słabym procesorze najdłużej trwa właśnie „przeczytanie” tych fragmentów przez model, zanim napisze pierwsze słowo. Dlatego liczy się, ile tekstu trafia do pytania.
Krok po kroku: Gemma na Ollamie z Twoimi plikami
Zakładam, że masz już zainstalowaną Ollamę. Jeśli nie, zacznij od poradnika jak uruchomić model AI lokalnie.
Krok 1: Pobierz Gemmę i model do indeksowania
W terminalu (w Windows: PowerShell) wpisz:
ollama pull gemma4:e4b
ollama pull embeddinggemma
U mnie gemma4:e4b (6,6 GB) pobierała się 6 min 44 s, a embeddinggemma (621 MB) 29 s, przy ok. 35 MB/s. embeddinggemma to model Google do indeksowania tekstu, trenowany na danych w ponad 100 językach, więc dobrze radzi sobie z polskim (Ollama). Mniejszy wariant gemma4:e2b zajmuje 4,6 GB (biblioteka Ollamy). Porównanie obu modeli znajdziesz niżej.
Krok 2: Zainstaluj AnythingLLM Desktop
Pobierz program ze strony anythingllm.com/download. Wersja Desktop działa na Windows, macOS i Linuxie, a dokumenty zostają na Twoim urządzeniu (dokumentacja AnythingLLM).
Na Ubuntu 26.04 program za pierwszym razem się nie uruchomił. Pojawił się błąd error loading libfuse.so.2 i komunikat „AppImages require FUSE to run”. Pomogło doinstalowanie jednej małej paczki:
sudo apt install libfuse2t64
Skąd ten problem? Na Linuksie AnythingLLM jest jednym plikiem w formacie AppImage, który uruchamia się bez instalowania. Żeby taki plik wystartował, system rozpakowuje go „w locie” jako wirtualny dysk, a do tego potrzebna jest biblioteka FUSE (Filesystem in Userspace) w starszej wersji 2. Nowe wydania Ubuntu mają domyślnie tylko FUSE 3, więc wersję 2 trzeba dograć ręcznie (dokumentacja AppImage). Od Ubuntu 24.04 paczka nazywa się libfuse2t64 zamiast libfuse2. U mnie miała 91 kB i przy instalacji niczego nie usunęła. Na Windows i macOS ten krok nie dotyczy.
Instalator na Linuksie pobiera też własny silnik Ollamy. Nie musisz go używać: w kolejnym kroku podłączysz AnythingLLM do Ollamy, którą już masz, razem z pobranymi modelami.
Krok 3: W kreatorze wybierz Ollamę i popraw model
Kreator na starcie sam proponuje model „najlepszy dla Twojego sprzętu”. U mnie był to Qwen3 Vision 4B z wbudowanego dostawcy AnythingLLM. Żeby użyć Gemmy, kliknij Manual set up i wybierz dostawcę Ollama.
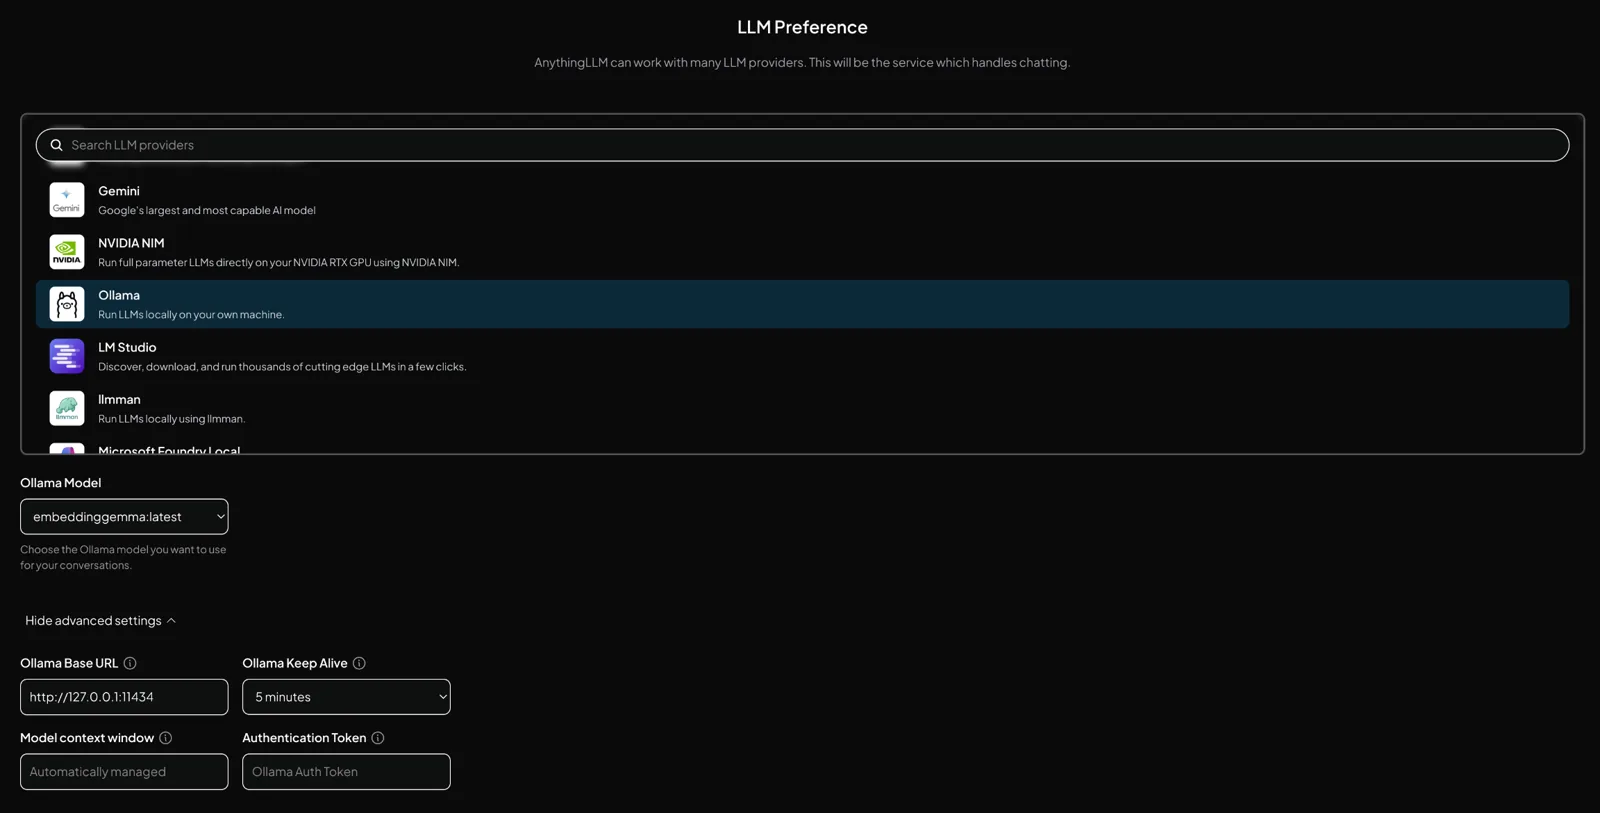
Tu jest pierwsza pułapka. Pole Ollama Model samo ustawiło się na embeddinggemma:latest, czyli model do indeksowania, który nie nadaje się do rozmowy. Zmień je na gemma4:e4b. Adres Ollamy (http://127.0.0.1:11434) kreator uzupełnił sam.
W Show advanced settings zmień też Ollama Keep Alive z 5 minut na 1 hour. Ollama domyślnie zwalnia model z pamięci po 5 minutach bezczynności (FAQ Ollamy), a ponowne wczytanie trwało u mnie około 30 sekund przy każdym pytaniu po przerwie.
Krok 4: Ustaw EmbeddingGemma jako model do indeksowania
Kreator w ogóle nie zapytał o model do indeksowania. Na ekranie podsumowania widać tylko „AnythingLLM Embedder”, czyli wbudowany model all-MiniLM-L6-v2, trenowany głównie na tekstach angielskich (AnythingLLM).
Zmień to od razu, przed dodaniem dokumentów: ikona klucza w lewym dolnym rogu, potem AI Providers → Embedder. Wybierz Ollama i model embeddinggemma:latest, kliknij Save changes.
Uwaga: model do indeksowania wybierz przed wgraniem plików. Po jego zmianie dokumenty trzeba usunąć i zaindeksować od nowa (AnythingLLM).
Krok 5: Zmniejsz rozmiar fragmentów do 1000 znaków
W tym samym menu otwórz Text Splitter & Chunking. U mnie Text Chunk Size wynosił domyślnie 8192 znaki. To dużo, bo EmbeddingGemma przyjmuje najwyżej 2048 tokenów (tak pokazuje ollama show embeddinggemma), a duże fragmenty wydłużają tekst, który Gemma musi przeczytać przy każdym pytaniu.
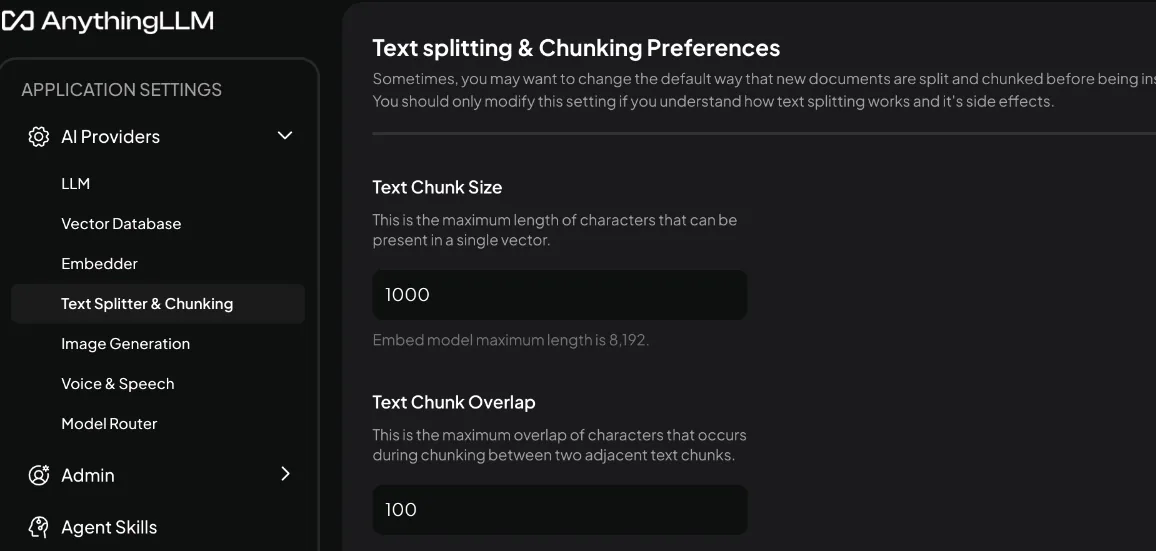
Ustawiłem 1000 znaków i zakładkę (Text Chunk Overlap) 100. Program ostrzega, że zmiana wyczyści zapisane wcześniej dokumenty, dlatego zrób to przed ich dodaniem.
Krok 6: Dodaj pliki przez menedżer dokumentów, nie do czatu
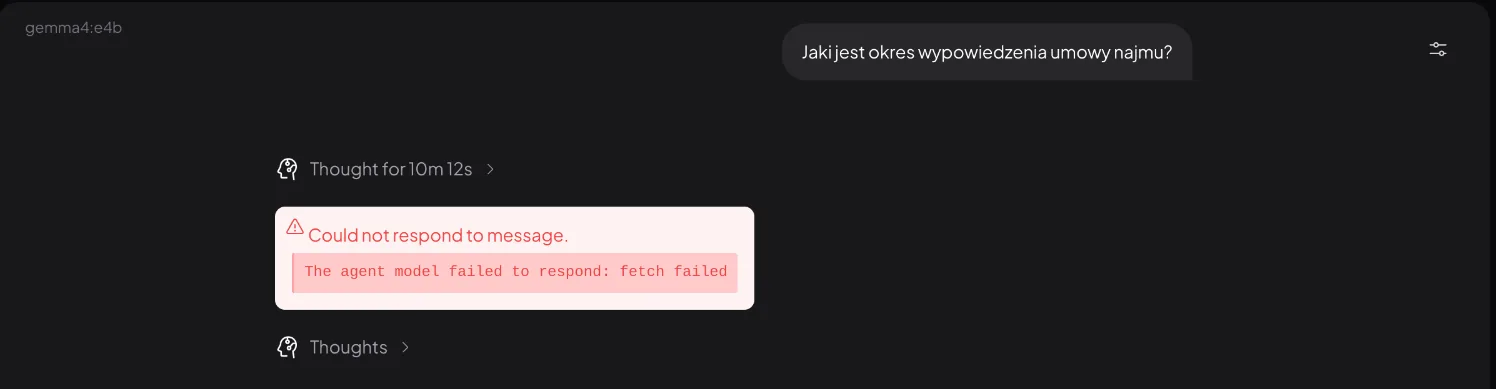
Najprostsze wydaje się przeciągnięcie PDF-ów do okna czatu. Tak zrobiłem za pierwszym razem i to był błąd. Pliki dostały etykietę „Added as context!”, czyli ich cały tekst trafił do pytania: 3593 tokeny z czterech PDF-ów. Po 10 minutach czytania (workspace był jeszcze w domyślnym trybie Agent, patrz krok 7) zamiast odpowiedzi pojawił się błąd.
Właściwa droga to menedżer dokumentów. Kliknij ikonę strzałki obok nazwy workspace’u (u mnie „My Workspace”, program tworzy go sam), wgraj pliki, zaznacz je, kliknij Move to Workspace, a potem Save and Embed.
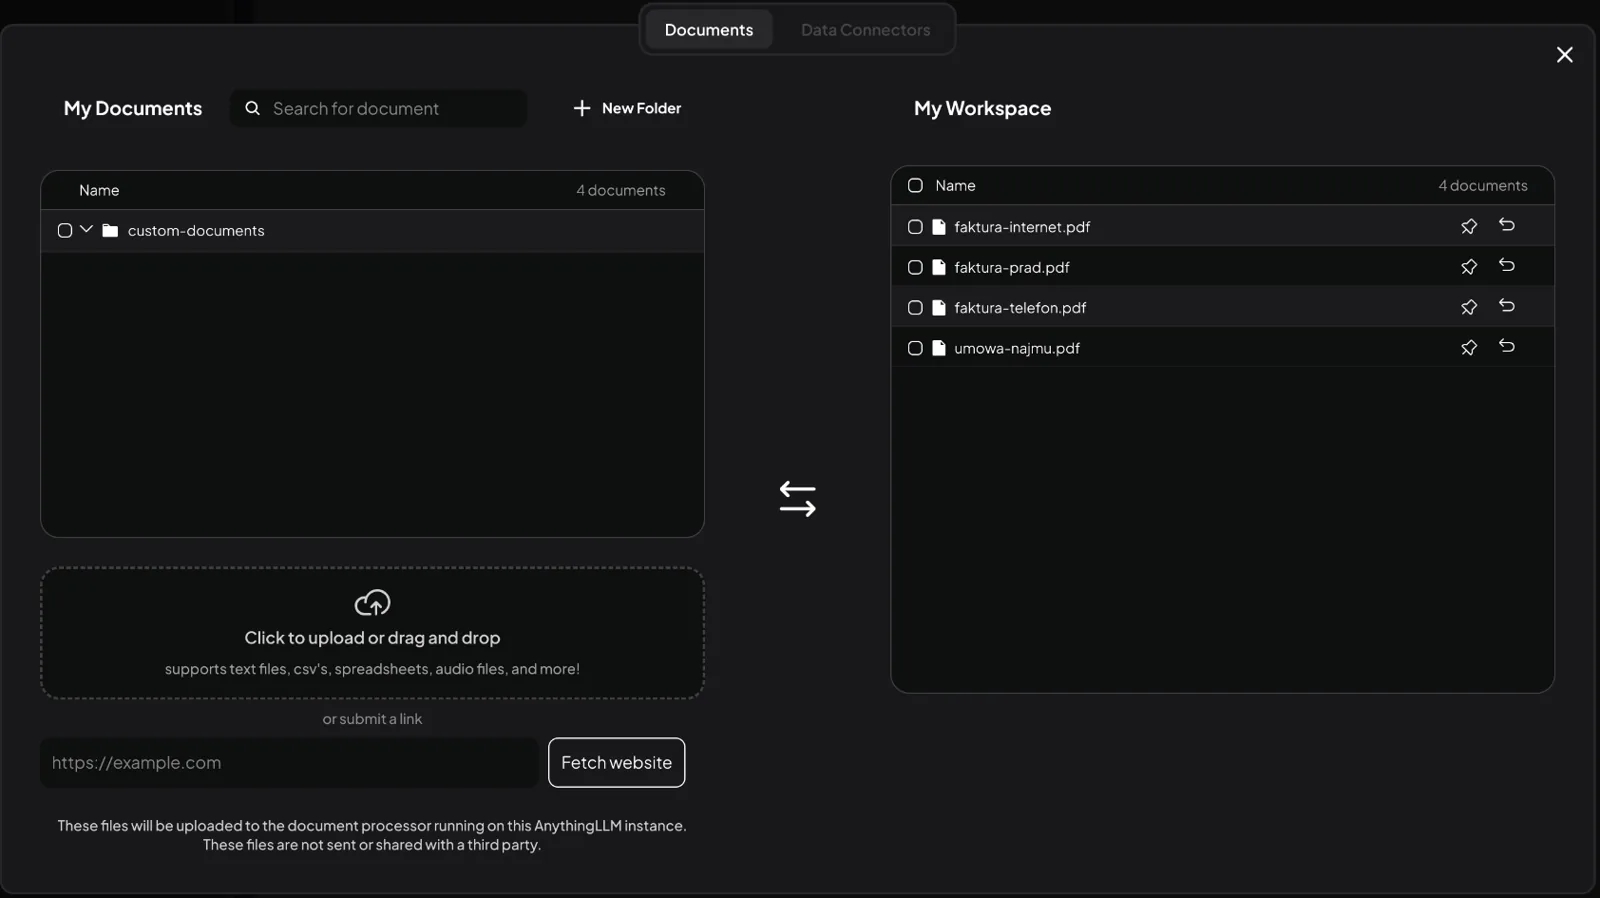
Indeksowanie czterech PDF-ów zajęło u mnie około 32 sekund. Umowa została podzielona na 10 fragmentów, każda faktura na jeden.
Krok 7: Przełącz czat w tryb Query
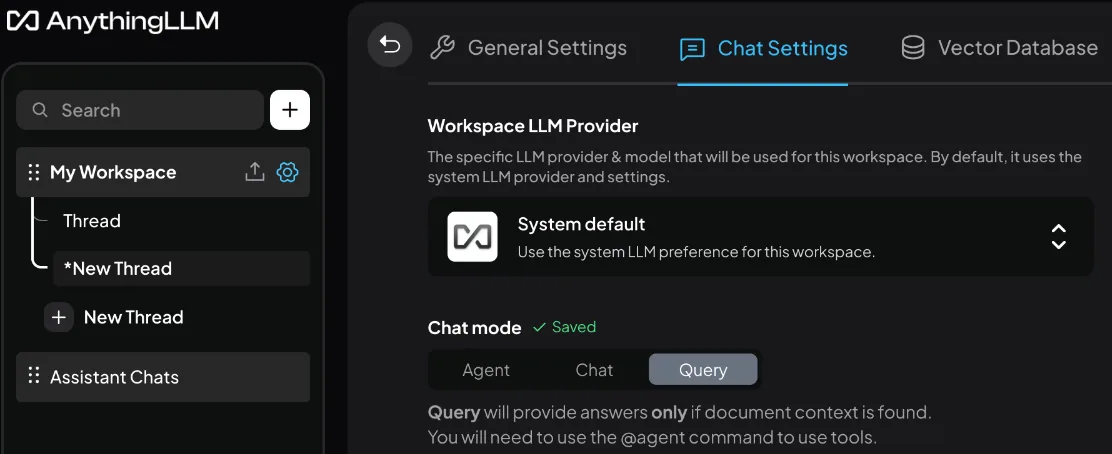
To najważniejsza zmiana. Workspace w AnythingLLM 1.17 startuje w trybie Agent. Dokumentacja potwierdza, że od wersji 1.11.1 to ustawienie domyślne dla nowych workspace’ów (AnythingLLM: tryby czatu).
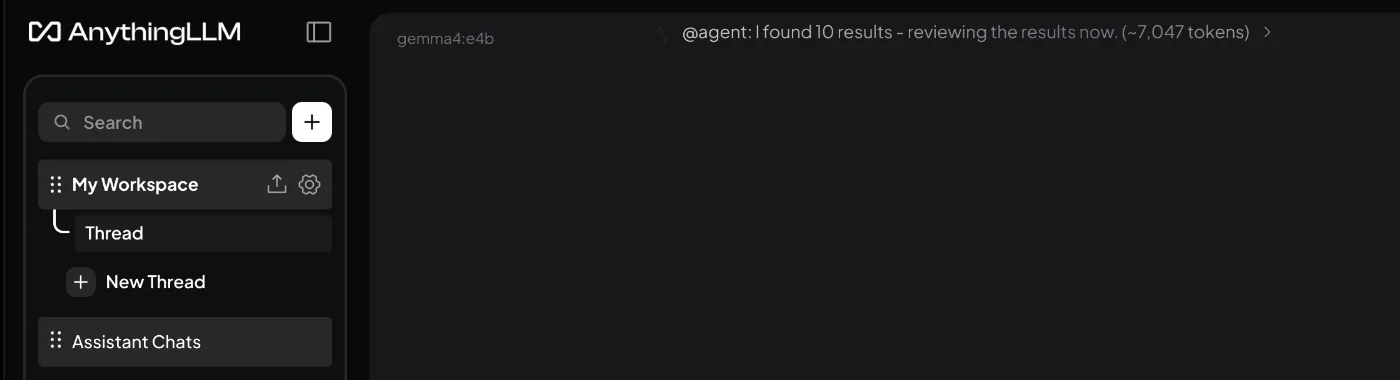
W moim teście agent na pytanie o okres wypowiedzenia z mojej umowy nie zajrzał do dokumentów, tylko uruchomił wyszukiwarkę internetową z zapytaniem „okres wypowiedzenia umowy najmu w Polsce”. Sama decyzja o wyszukaniu zajęła Gemmie 2 minuty, a potem zabrała się za czytanie ok. 7 tys. tokenów wyników z sieci.
Kliknij koło zębate przy nazwie workspace’u, wejdź w Chat Settings i w Chat mode wybierz Query. Zmiana zapisuje się od razu. W tym trybie program odpowiada tylko na podstawie Twoich dokumentów, a gdy nic nie znajdzie, mówi o tym zamiast zgadywać.
Krok 8: Każde nowe pytanie zadawaj w nowym wątku
AnythingLLM dołącza do pytania historię rozmowy (domyślnie 20 poprzednich wiadomości). Każda wiadomość z historii to więcej tekstu do przeczytania. Drugie pytanie w tym samym wątku miało u mnie 2111 tokenów zamiast ok. 1600, co przy tempie z pierwszego pytania (ok. 10 tokenów na sekundę) oznacza mniej więcej minutę dłuższego czytania. Na wolnym procesorze każda taka minuta się liczy. Jeśli pytanie nie nawiązuje do poprzedniego, kliknij New Thread.
Wyniki: co odpowiedziała Gemma
Zadałem trzy pytania, na które znałem odpowiedź. Model gemma4:e4b odpowiedział poprawnie na wszystkie.
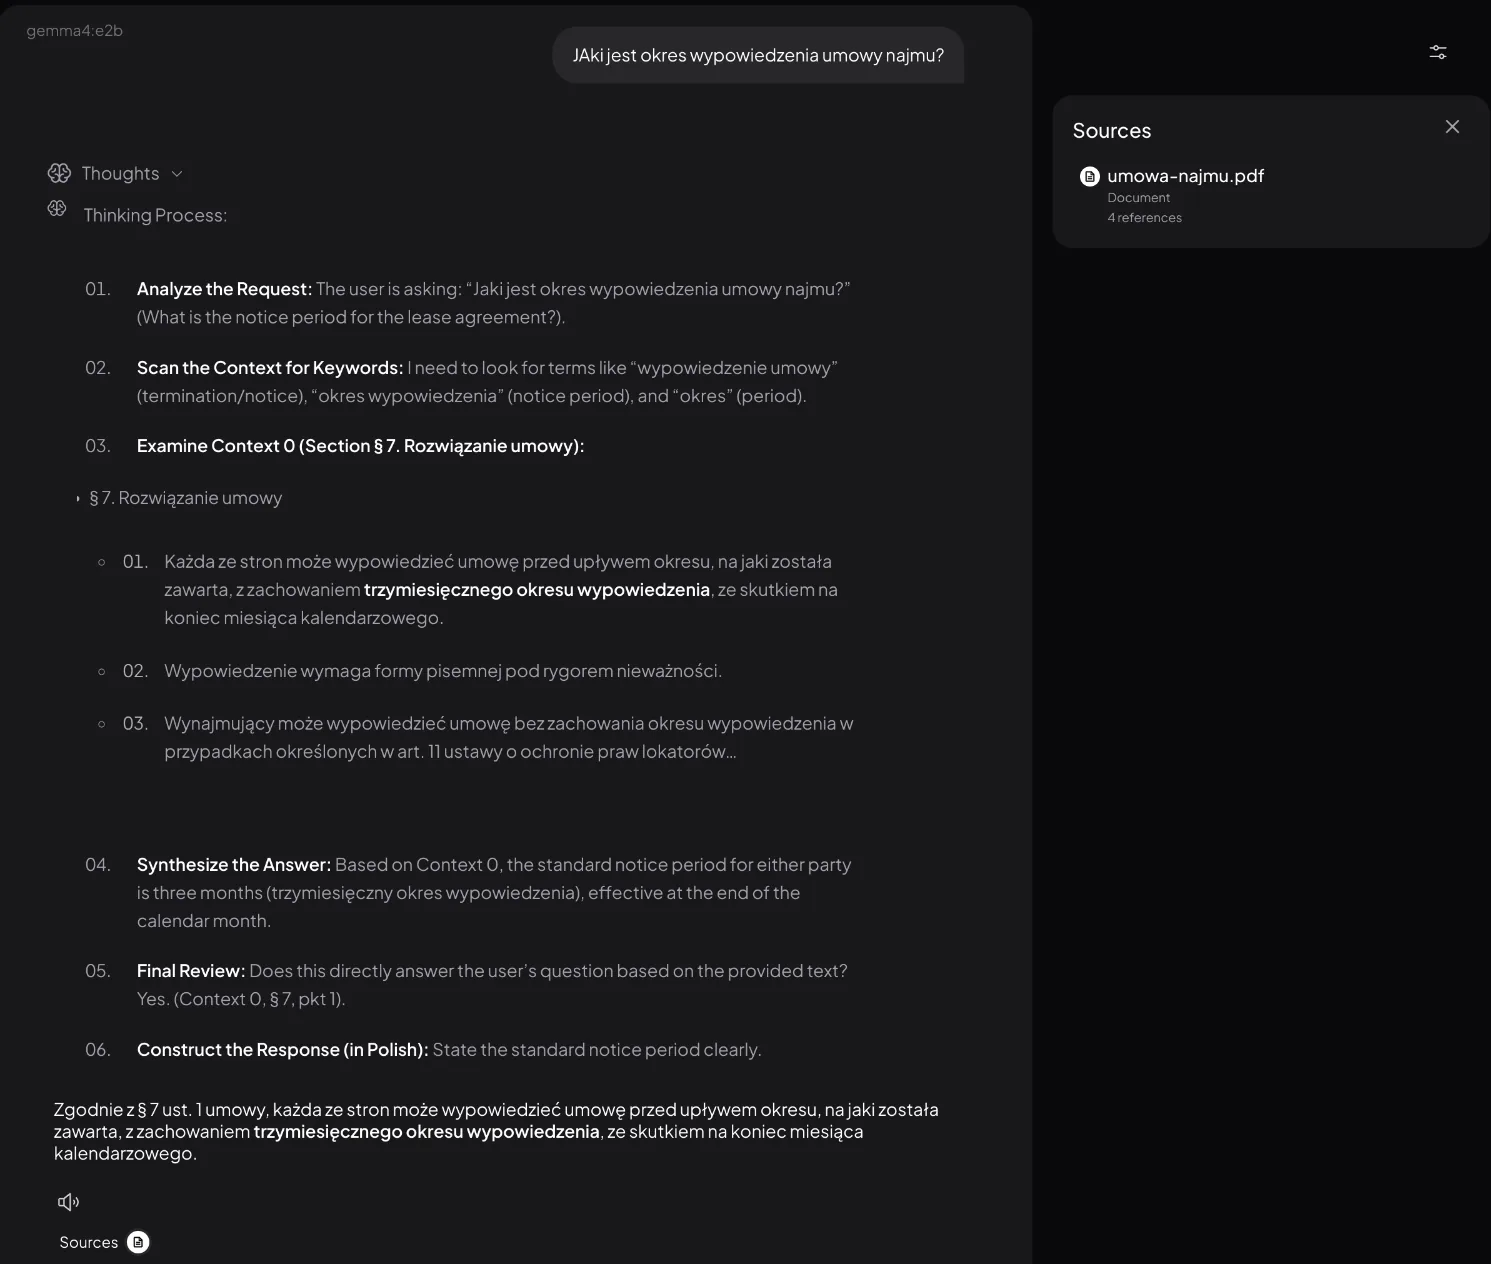
- „Jaki jest okres wypowiedzenia umowy najmu?” Trzy miesiące, ze skutkiem na koniec miesiąca kalendarzowego. To zgadza się z § 7 umowy. W źródłach program pokazał
umowa-najmu.pdf. - „Wypisz terminy płatności i kwoty z faktur za wrzesień.” Wszystkie trzy kwoty i terminy były poprawne. Jedyny zgrzyt: w nagłówkach zostały dopiski „(Kontekst 0)”, „(Kontekst 1)”, czyli wewnętrzne oznaczenia fragmentów.
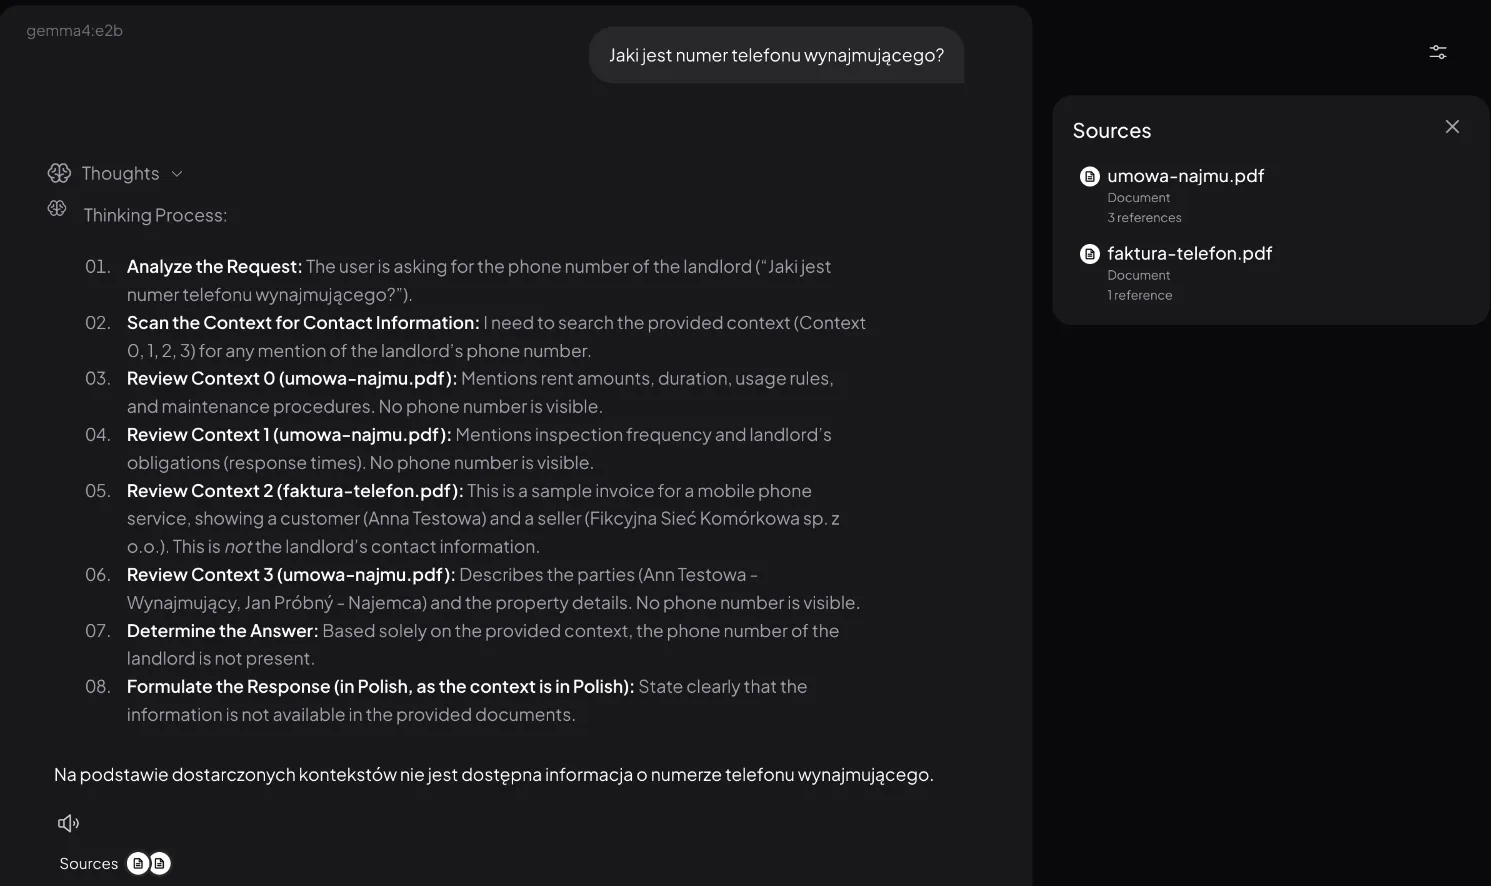
- „Jaki jest numer telefonu wynajmującego?” To było pytanie-pułapka, bo tego numeru nie ma w żadnym dokumencie. Gemma nie zmyśliła numeru, tylko odpisała, że w dostarczonych dokumentach go nie ma.
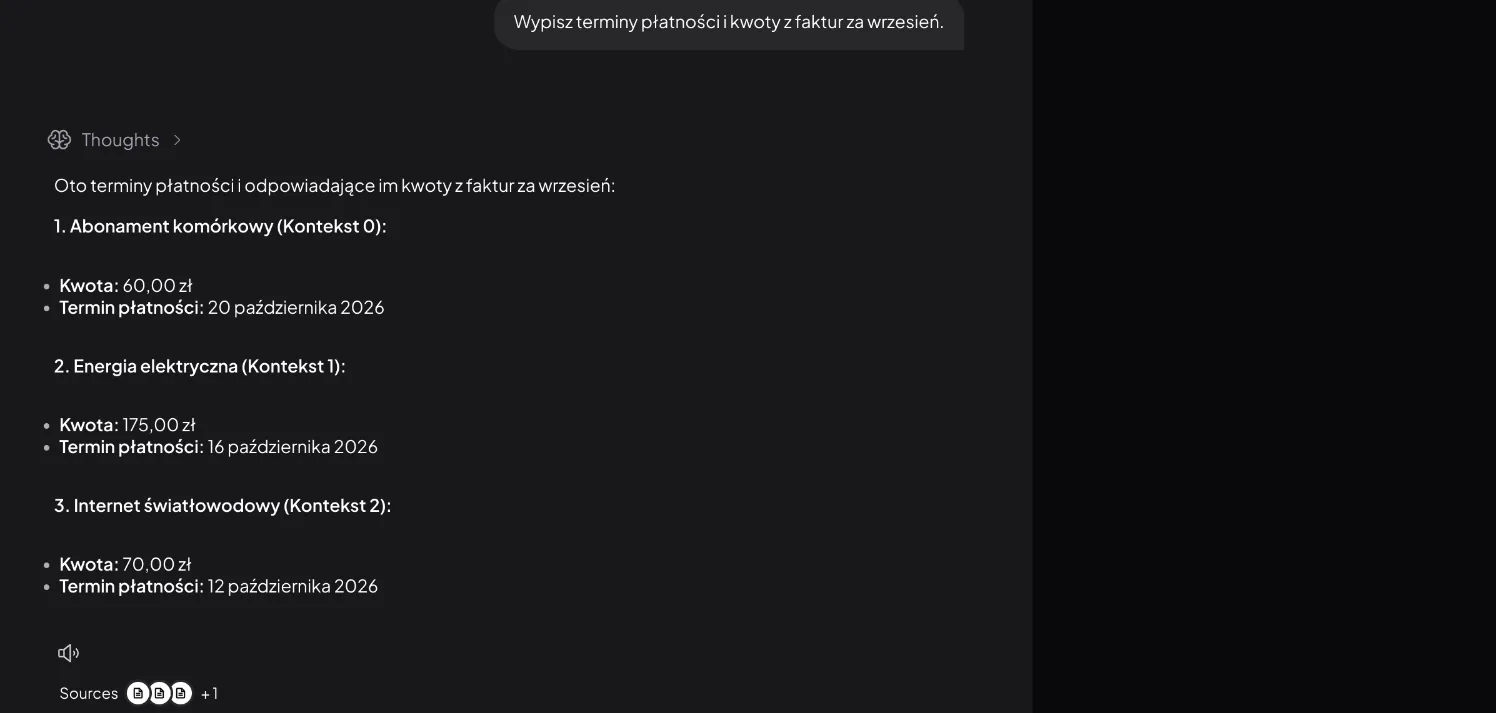
Model najpierw „myśli” po angielsku, a dopiero potem pisze odpowiedź po polsku. Ten tok rozumowania rozwiniesz, klikając Thoughts. Widać w nim, z którego paragrafu wzięła się odpowiedź, co ułatwia jej sprawdzenie.
Ile to trwa na starym laptopie
Czasy pochodzą z logu Ollamy. „Czytanie” to przetworzenie fragmentów dokumentów i pytania, „pisanie” to generowanie odpowiedzi razem z myśleniem modelu. Token to kawałek słowa.
| Pytanie | Model | Tekst w pytaniu | Czytanie | Pisanie | Razem |
|---|---|---|---|---|---|
| 4 PDF-y przeciągnięte do czatu (tryb Agent) | e4b | 3593 tokeny | przerwane | – | błąd po 10 min |
| Okres wypowiedzenia | e4b | 1614 tokenów | 2 min 42 s | 1 min 43 s | 4 min 25 s |
| Terminy z faktur (2. pytanie w wątku) | e4b | 2111 tokenów | 6 min 38 s | 3 min 52 s | 10 min 30 s |
| Numer telefonu (pułapka) | e4b | 1581 tokenów | 5 min 29 s | 2 min 14 s | 7 min 43 s |
| Okres wypowiedzenia | e2b | 1614 tokenów | 2 min 26 s | 1 min 12 s | 4 min 5 s* |
| Numer telefonu (pułapka) | e2b | 1581 tokenów | 2 min 30 s | 1 min 21 s | 3 min 51 s |
* razem z ok. 30 s wczytywania modelu do pamięci.
Czytanie szło z prędkością od ok. 5 do 11 tokenów na sekundę. Przy dwóch późniejszych pytaniach z e4b spadło do ok. 5 tokenów na sekundę i nie ustaliłem dlaczego. Laptop był podłączony do zasilacza, a pod koniec ostatniego z tych pytań w tle zaczął się pobierać drugi model.
Licznik pod odpowiedzią w AnythingLLM (u mnie „1m 12s”) pokazuje tylko czas pisania, a nie cały czas czekania od wysłania pytania.
Ostrzeżenie: zamknij przeglądarkę na czas pytania. Przy otwartym Chrome Gemma zajmowała 7,4 GB RAM, cała pamięć wymiany (swap) była zajęta, a okno AnythingLLM chwilami przestawało się rysować. Czytanie dokumentu zwolniło wtedy mniej więcej trzykrotnie.
gemma4:e2b czy e4b?
Mniejszy gemma4:e2b odpowiedział na pytanie o wypowiedzenie tak samo poprawnie jak e4b, a na pułapce też nie zmyślił numeru, tylko odpisał, że w dokumentach nie ma tej informacji.
Szybciej było jednak tylko trochę: około 4 minut zamiast 4,5. Na moim laptopie e2b pisze wyraźnie szybciej (5,8 zamiast 3,4 tokena na sekundę), ale czytanie fragmentów trwa prawie tyle samo (11 zamiast 10 tokenów na sekundę), a to ono zajmuje większość czasu. Na dysku e2b zajmuje 4,6 GB zamiast 6,6 GB.
Werdykt: na komputerze bez karty graficznej wybór między e2b a e4b zmienia niewiele. Więcej daje to, ile tekstu trafia do pytania: tryb Query, fragmenty po 1000 znaków i nowy wątek na każde pytanie.
Jak przyspieszyć odpowiedzi
- Sprawdź, czy model działa na karcie graficznej. Wpisz w terminalu
ollama ps. U mnie w kolumnie PROCESSOR było100% CPU, czyli cała praca na procesorze.100% GPUoznacza pracę w całości na karcie graficznej (FAQ Ollamy). Jeśli masz kartę, a widzisz100% CPUalbo podział CPU/GPU, karta może nie być obsługiwana przez Ollamę albo model nie mieści się w jej pamięci. Wtedy spróbuj mniejszego wariantu. - Nie wklejaj całych dokumentów. Pliki dodane do czatu albo przypięte pinezką trafiają do pytania w całości. Dokumentacja też ostrzega, że to spowalnia odpowiedzi (AnythingLLM).
- Ogranicz liczbę fragmentów. W ustawieniach workspace’u, w zakładce Vector Database, opcja Max Context Snippets określa, ile fragmentów trafia do modelu. Dokumentacja zaleca 4-6 (AnythingLLM). U mnie przy odpowiedziach widać było 4 odwołania do dokumentów.
- Trzymaj model w pamięci. Keep Alive ustawiony na 1 godzinę oszczędza ok. 30 s wczytywania przy każdym pytaniu po przerwie.
Najczęstsze problemy
- Program odpowiada wiedzą z internetu zamiast z Twojego pliku: workspace jest w trybie Agent. Przełącz go na Query (krok 7).
- „Could not respond to message… fetch failed”: u mnie pojawiło się po ponad 10 minutach, gdy pliki były przeciągnięte do czatu, a workspace był w trybie Agent. Usuń je z wiadomości, dodaj przez menedżer dokumentów i zapytaj w nowym wątku.
- AppImage nie startuje na Ubuntu: zainstaluj
libfuse2t64(krok 2). - Zamknięcie okna nie zamyka programu: krzyżyk chowa AnythingLLM do zasobnika systemowego, a program dalej działa w tle.
- Odpowiedź „There is no relevant information in this workspace”: w trybie Query to znaczy, że program nie znalazł pasujących fragmentów. Sprawdź też, czy PDF ma warstwę tekstu, czyli czy da się w nim zaznaczyć i skopiować tekst.
Najczęściej zadawane pytania
Czy moje pliki wychodzą poza komputer?
W trybie Query z Ollamą i EmbeddingGemmą wszystko liczy się lokalnie. Menedżer dokumentów sam informuje, że pliki nie są wysyłane do nikogo trzeciego. Uważaj tylko na tryb Agent, bo on potrafi sam uruchomić wyszukiwarkę internetową, co pokazał mój test. Anonimowa telemetria AnythingLLM była u mnie domyślnie włączona. Wyłączysz ją w Ustawienia → Privacy & Data (AnythingLLM: prywatność).
Czy Gemma na Ollamie rozumie polskie dokumenty?
W moim teście tak: wszystkie odpowiedzi były po polsku i zgodne z treścią umowy i faktur. Model myśli po angielsku, ale na moje polskie pytania odpowiadał po polsku.
Czy to ma sens na starym laptopie?
Do kilku pytań dziennie, gdy możesz poczekać 4-10,5 minuty, tak. Do szybkiej rozmowy nie. Jeśli dokumenty nie są poufne, szybsze będą narzędzia w chmurze z naszego rankingu narzędzi AI do analizy dokumentów.
Czy zamiast AnythingLLM mogę użyć czegoś innego?
Tak, czat z dokumentami obsługują też np. Open WebUI i LM Studio. Wybrałem AnythingLLM, bo instaluje się jak zwykły program, bez Dockera i konfiguracji serwera. Tych alternatyw w tym teście nie sprawdzałem.